

최신 연구
[강석형 교수] GPU 병렬 파이프라인 기반 Global Routing 가속 프레임워크
- 등록일2026.10.26
- 조회수49
-

교수강석형
[연구자명]
- 김민석, 김소이, 이원석
[연구제목]
- GPU 병렬 파이프라인 기반 Global Routing 가속 프레임워크
- [연구내용 요약]
- Global routing의 런타임 감소를 목표로 GPU 병렬 파이프라인 가속 프레임워크를 제안하였다. InstantGR을 baseline으로, 라우팅 품질은 유지하면서 다음과 같은 기법을 도입한다.
[Methodology]
1. RSMT 생성: CPU-GPU hybrid FLUTE
핀 9개 이하 넷은 CPU(FLUTE LUT), 10개 이상 넷은 GPU-FLUTE로 처리한다. 파싱 중 발견한 대형 넷을 GPU로 비동기 전송해 CPU 및 GPU의 연산을 중첩 실행한다.
2. DAG 구성: Tree-center
Leaf peeling으로 트리의 중심 노드를 찾아 루트로 지정하고 DFS로 DAG를 구성한다. 이를 통해 DAG depth를 줄여 GPU 동기화 횟수를 감소시킨다.
3. GPU batch generation
CPU가 순차 수행하던 넷간 충돌 검사 및 batch 배정을 GPU로 이전한다. 넷 하나당 warp를 할당해 후보 batch들의 bitmap을 동시에 읽으며, 넷이 들어갈 batch만 점유 영역을 기록한다. 기록 충돌은 atomic 연산으로 감지해 재탐색한다.
4. Augmented via cost 및 Prefix-sum 갱신
라우팅 수요가 변경된 특정 영역과 그 인접 영역의 via cost만을 계산한다. 마찬가지로, 변경된 영역이 속한 트랙의 prefix-sum만 선택적으로 재계산하며, 변경 영역이 전체 grid의 20%를 넘으면 전체 계산 모드로 전환한다.
5. Augmented wire-demand commit
새 라우팅이 실제로 지나간 트랙만 수요를 반영하고 임시 배열을 초기화한다. 이 때 기록한 변경 위치를 다음 batch의 코스트 갱신 대상으로 전달해, batch간 정보를 재사용한다.
[Result]
ISPD 2024 공식 벤치마크 4종에서 Score 변화를 ±0.04% 이내로 유지하면서 런타임을 1.37×~3.27×로 단축한다. 회로 규모가 클수록 가속 배율이 증가하는 경향을 확인하였다.
[성과와 관련된 이미지 및 설명]
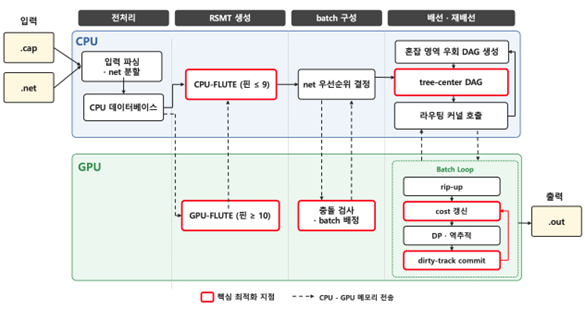
그림 1. 제안 프레임워크 전체 구조
CPU, GPU 분담 구조로, 빨간 테두리가 핵심 최적화 지점이다.
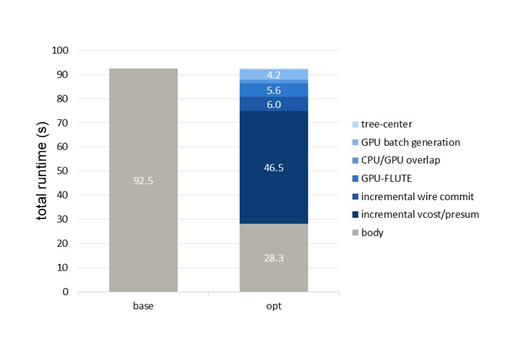
그림 2. mempool_group 실행 시간 방법론별 분석
가속 방법론별 시간 단축에 기여한 정도를 누적한 그래프이다. 런타임을 92.49s에서 28.29s로 3.27배 줄였다.
[연구결과의 진행상태 및 향후 계획]
[진행 상태]
∙ C++/CUDA로 5가지 가속 기법을 구현하고 하나로 통합
∙ ISPD 2024 공식 벤치마크 4종으로 성능 및 품질 검증 완료
∙ 가속 기법별 기여도 분리 분석 완료
∙ 소스 코드 및 빌드, 실행, 검증 절차를 GitHub에 공개
[향후 계획]
∙ 메모리 사용량과 처리 효율을 개선하여 대규모 설계를 처리할 수 있도록 최적화
[수상실적]
2026 한국 대학생 반도체 설계 경진대회 금상 수상 >> 공식 홈페이지 바로가기