

최신 연구
-
[이선규 교수] A 23-Gb/s/line 188-fJ/b Single-Ended Transceiver With Self-Calibrating Coupling-Balanced Crosstalk Cancellation for Ultra-Dense Chiplet Interfaces
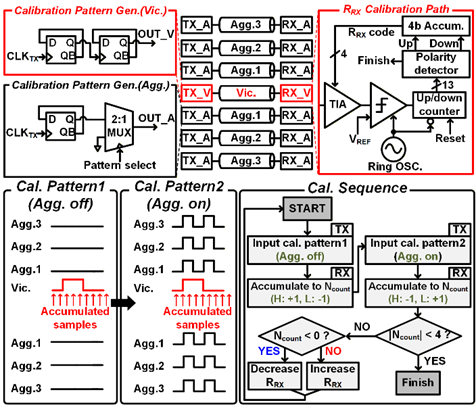
[연구자명] 김승범 [연구제목] A 23-Gb/s/line 188-fJ/b Single-Ended Transceiver With Self-Calibrating Coupling-Balanced Crosstalk Cancellation for Ultra-Dense Chiplet Interfaces [연구내용 요약] 초고밀도 D2D 인터페이스에서 인접한 다중 채널의 Capacitive/Inductive Coupling을 분석하여 전체 Crosstalk을 최소화하는 최적 수신기 입력 저항(RRX)을 도출함. 또한 두 가지 Calibration Pattern과 비동기 샘플링을 이용해 Crosstalk에 따른 Pulse Width 변화량을 검출하고, 이를 바탕으로 수신기 입력 저항을 자동 조절하는 Self-Calibration 회로를 구현함. [성과와 관련된 이미지 및 설명] 인접 채널의 활성화 여부에 따른 수신 신호의 Pulse Width 변화량을 비동기 샘플링으로 검출한다. 검출된 변화량의 극성을 바탕으로 수신기 입력 저항을 조절하여 Crosstalk이 최소화되는 최적값으로 자동 보정한다. 2:1 Serializer와 TX Driver로 구성된 송신기 및 입력 저항 조절이 가능한 TIA 기반 수신기 구조를 나타낸다. 수신기에서는 Feedback 회로와 Coarse/Fine Tuning을 통해 입력 저항을 조절하며, Capacitive/Inductive Coupling에 의한 Crosstalk이 최소화되도록 설계하였다. 인접 채널에서 발생하는 Crosstalk으로 인해 수신 신호의 Eye Opening이 감소하지만, 제안한 Self-Calibration을 통해 수신기 입력 저항을 최적화하면 Eye Opening이 회복됨을 확인하였다. 실제 칩 측정 결과, 23 Gb/s/line에서 BER 10⁻¹² 미만을 기준으로 0.56 UI의 수평 마진과 164 mV의 수직 마진을 확보하였다. [연구결과의 진행상태 및 향후 계획] 초고밀도 D2D 병렬 인터페이스에서 다중 채널 Crosstalk을 최소화하는 Self-Calibration 회로를 구현하고, 실제 칩 측정을 통해 성능 검증을 완료함. 향후 이를 기반으로 정상 데이터 전송 중에도 Crosstalk 변화에 대응할 수 있는 Background Calibration 기반 송수신기 기술을 연구할 계획임. [논문실적] IEEE Transactions on Circuits and Systems I (TCAS-I)에 논문 게재
이선규 교수 2026.10.16 12 -
[이병훈 교수] POSTECH 나노전자시스템연구실, 국가반도체연구실(NSL) 우수성과 사례 선정
POSTECH 나노전자시스템연구실, 국가반도체연구실(NSL) 우수성과 사례 선정 POSTECH 반도체공학과 이병훈 교수 연구팀(나노전자시스템연구실, EESL)의 연구성과가 「2026 국가반도체연구실(NSL) 우수성과 사례집」에 소개되었습니다. 나노전자시스템연구실은 ZnO·Te 등 상보성 극박막 상복합 소재를 활용한 차세대 반도체 소자 및 신개념 회로 기술을 연구하고 있습니다. 소재 개발에서부터 소자 및 집적 논리회로 구현·실증까지 연결하여 차세대 반도체 원천기술 확보를 목표로 하고 있습니다. 이번 사례집에는 「극박막 상복합 소재기반 신소자 및 아키텍처 연구」가 대표 연구성과로 소개되었습니다. 연구팀은 극박막 상복합 ZnO에 양자우물 구조를 형성해 1/f noise를 소자 단계에서 억제하는 전하 수송 기술을 구현하였으며, 기존 ZnO 트랜지스터 대비 10 Hz에서 약 1,000배 낮은 잡음 수준을 확보했습니다. 이를 통해 별도의 잡음 보정 회로에 따른 면적·전력·설계 복잡도를 줄일 수 있으며, 향후 바이오·가스 센서와 정밀 아날로그 회로 등 저잡음 반도체 소자 분야에 활용될 것으로 기대됩니다. 자세한 연구 내용과 주요 성과는 첨부된 「2026 국가반도체연구실(NSL) 우수성과 사례집」에서 확인하실 수 있습니다.
이병훈 교수 2026.09.22 132 -
[정윤영 교수] Highly Linear and Symmetric Multilevel IGZO 2T Device Utilizing Identical Potentiation and Depression Pulses
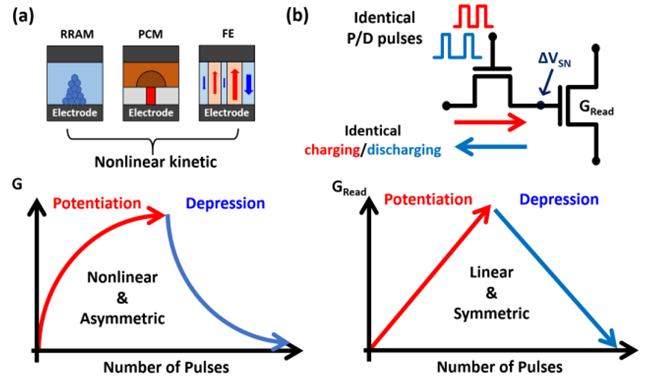
정윤영 교수 연구팀은 사람의 뇌가 정보를 기억하고 학습하는 방식을 닮은 IGZO 기반 인공지능 반도체 소자를 개발하였다. 인공지능이 학습하려면 정보의 중요도를 조금씩 조절해야 하는데, 연구팀은 이를 반도체에 흐르는 전류를 여러 단계로 바꾸는 방식으로 구현하였다. 기존의 소자는 학습이 진행될수록 전류 변화가 일정하지 않아, 원하는 값을 만들기 위해 전기 신호를 계속 조절해야 하는 문제가 있었다. 때문에 연구팀은 단 2개의 IGZO 트랜지스터를 이용해, 같은 전기 신호를 반복해서 사용해도 전류가 일정한 간격으로 증가하고 감소할 수 있는 새로운 동작 방식을 제안하였다. 개발된 소자는 전류 상태를 220단계로 세밀하게 조절할 수 있었으며, 손글씨 숫자 인식 시뮬레이션에서도 3% 미만의 오류율과 이상적인 소자 대비 99% 이상의 성능을 보였다. 이번 연구는 이러한 성과를 인정받아 IEEE Electron Device Letters에 게재 승인되었다. [연구자명] 성수원, 하태준, 정상욱, 강대환, 정윤영(지도교수) [연구제목] Highly Linear and Symmetric Multilevel IGZO 2T Device Utilizing Identical Potentiation and Depression Pulses [연구내용 요약] 최근 인공지능 기술이 발전하면서, 사람의 뇌처럼 정보를 기억하고 학습할 수 있는 반도체가 주목받고 있다. 사람의 뇌가 시냅스의 연결 강도를 바꾸며 학습하는 것처럼, 인공지능 반도체는 소자에 흐르는 전류를 여러 단계로 조절해 정보의 중요도인 ‘시냅스 가중치(weight)’를 저장한다. 정확한 학습을 위해서는 전기 신호를 줄 때마다 가중치가 일정하게 증가하거나 감소하는 것이 중요하다. 하지만 기존 시냅스 소자는 학습이 진행될수록 전류 변화가 불규칙해져, 원하는 값을 만들기 위해 신호의 크기나 시간을 계속 조절해야 하는 문제가 있었다. 연구팀은 이를 해결하기 위해 두 개의 IGZO 트랜지스터로 구성된 2T 시냅스 소자를 개발하였다. 두 트랜지스터의 특성이 서로 보완되도록 설계해, 같은 전기 신호를 반복해도 전류가 일정한 간격으로 증가하거나 감소하도록 만들었다. 그 결과, 개발된 소자는 220단계의 세밀한 상태 조절이 가능했으며, 손글씨 숫자 인식 시뮬레이션에서 3% 미만의 오류율과 이상적인 소자 대비 99% 이상의 성능을 보였다. 이는 단 2개의 트랜지스터만으로도 정확하고 효율적인 인공지능 학습이 가능함을 보여주었다는 점에서 중요한 의의를 가진다. [성과와 관련된 이미지 및 설명] (a) 기존에 연구되어 왔던 다양한 뉴메모리 소자는 같은 전기 신호를 반복해서 넣어도 전류 변화가 일정하지 않아, 가중치가 비선형적이고 증가/감소 방향도 서로 비대칭하게 변한다. 반면 (b) 본 연구의 IGZO 물질을 활용한 2Transistor 소자는, 동일한 형태의 전기 신호를 반복적으로 사용하면서도, 전류가 증가할 때와 감소할 때 모두 거의 일정하고 대칭적으로 변화하도록 설계되었다. 따라서 복잡한 신호 조절 없이도 보다 정밀한 인공지능 학습이 가능하다. (좌) 2T device 소자 구조와, (우) 실제 광학 현미경으로 본 구조 [연구결과의 진행상태 및 향후 계획] 본 연구진은 이번 연구의 IGZO 2T 인공지능 시냅스 기술을 바탕으로 더 많은 소자를 연결한 대규모 인공지능 반도체로 연구를 확장할 계획이다. 특히 복잡한 전기 신호 조절 없이도 가중치를 정밀하게 변화시킬 수 있다는 장점을 활용하여, 향후 보다 단순한 회로 구조로 높은 정확도의 인공지능 학습을 수행할 수 있는 저전력 인공지능 반도체 개발을 위한 연구를 이어갈 계획이다. [논문실적] IEEE Electron Device Letters [Accepted] DOI: 10.1109/LED.2026.3725232
정윤영 교수 2026.09.21 127 -
[정윤영 교수] 4-Transistor IGZO Ternary Content Addressable Memory Enabling Large-Scale Array Integration for In-Memory Computing
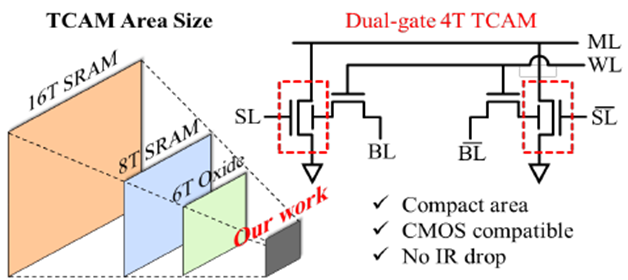
정윤영 교수 연구팀은 단 4개의 IGZO 트랜지스터만으로 원하는 데이터를 빠르게 찾아낼 수 있는 새로운 TCAM(Ternary Content Addressable Memory) 메모리를 개발하였다. TCAM은 저장된 여러 데이터와 찾고 싶은 데이터를 한꺼번에 비교할 수 있어, 인공지능과 빅데이터처럼 많은 정보를 빠르게 처리해야 하는 분야에 유용한 메모리이다. 기존 TCAM은 하나의 셀을 만들기 위해 보통 16개의 트랜지스터가 필요하지만, 연구팀은 위쪽과 아래쪽에서 모두 제어할 수 있는 dual-gate IGZO 트랜지스터를 활용해 이를 단 4개로 줄였다. 즉, 필요한 소자 수를 75% 줄여 더 작은 공간에 더 많은 메모리를 넣을 수 있게 한 것이다. 또한 메모리 규모가 커질수록 전기 신호가 약해질 수 있는 문제도 줄여, 대규모 메모리에서도 안정적으로 동작할 수 있도록 설계하였다. 이번 연구는 더 작고, 더 적은 전력으로, 많은 데이터를 빠르게 처리할 수 있는 차세대 인공지능 반도체 기술로의 가능성을 인정받아 IEEE Electron Device Letters에 게재 승인되었다. [연구자명] 서태원, 하태준, 손승현, 김선민, 정윤영(지도교수) [연구제목] 4-Transistor IGZO Ternary Content Addressable Memory Enabling Large-Scale Array Integration for In-Memory Computing [연구내용 요약] 인공지능의 성능을 향상시키기 위해서는, 수많은 데이터 속에서 필요한 정보를 얼마나 빨리 찾아내는지가 중요하다. 일반 메모리는 원하는 데이터를 하나씩 찾아가며 확인하지만, TCAM(Ternary Content Addressable Memory)은 여러 데이터를 한꺼번에 비교해 원하는 정보를 빠르게 찾을 수 있다. 때문에 인공지능이나 빅데이터처럼 많은 정보를 빠르게 처리해야 하는 분야에서 활용도가 높은 메모리이다. 다만 기존 TCAM은 하나의 메모리 셀을 만들기 위해 보통 16개의 트랜지스터가 필요해 많은 공간을 차지하는 문제가 있어왔다. 따라서 본 연구팀은 위와 아래 두 방향에서 전기적으로 제어할 수 있는 dual-gate IGZO 트랜지스터를 활용해, 같은 기능을 단 4개의 트랜지스터만으로 구현하였고, 더 작은 공간에 더 많은 메모리를 넣을 수 있음을 확인하였다. 또한, 특정 데이터 값을 비교하지 않아도 되는 ‘don’t care’ 기능을 구현해, 보다 유연하게 데이터를 검색할 수 있도록 했다. 이와 함께 메모리 규모가 커질수록 전기 신호가 약해져 오류가 발생할 수 있는 문제를 새로운 회로 구조로 줄여, 많은 메모리 셀을 연결한 대규모 환경에서도 안정적으로 동작할 수 있도록 설계했다. 실제 제작한 소자는 100억 번 이상 반복해서 동작해도 안정적인 성능을 보였다. 또한 256×256개의 메모리 셀을 연결한 상황을 시뮬레이션한 결과, 약 350 ps라는 매우 빠른 속도로 데이터를 검색할 수 있었다. 종합적으로 이번 연구는, 앞으로 더 작고 빠른 인공지능 반도체와 메모리 기반 연산 기술을 만드는 데 활용될 수 있을 것으로 기대된다. [성과와 관련된 이미지 및 설명] 위 그림은 기존 TCAM과 연구팀이 새롭게 개발한 TCAM의 구조를 비교한 그림이다. 기존 SRAM 기반 TCAM은 데이터를 저장하고 검색하기 위해 많은 트랜지스터가 필요하지만, 연구팀은 dual-gate IGZO 트랜지스터를 활용해 같은 기능을 단 4개의 트랜지스터만으로 구현하였다. 또한 검색 신호가 전달되는 방식을 새롭게 설계해, 메모리의 크기가 커질수록 발생할 수 있는 전압 감소 문제를 줄였다. [연구결과의 진행상태 및 향후 계획] 본 연구진은 이번 연구에서 개발한 4-transistor IGZO TCAM 기술을 바탕으로 더 많은 데이터를 작은 면적에서 빠르게 검색할 수 있는 고집적 메모리 기술에 대한 연구를 이어갈 계획이다. 특히 IGZO 트랜지스터는 비교적 낮은 온도에서 제작할 수 있고 여러 층으로 쌓는 구조에도 적용할 수 있기 때문에, 향후 반도체 소자를 수직으로 적층하여 저장할 수 있는 데이터의 양을 더욱 증가시키는 연구로 확장할 수 있다. 논문에서도 제안된 구조가 4F²급의 수직·적층형 소자 구조로 확장될 가능성을 제시하고 있다. [논문실적] IEEE Electron Device Letters [Accepted] DOI: 10.1109/LED.2026.3725692
정윤영 교수 2026.09.21 119 -
[이선규 교수] A 40-Gb/s 0.6-VDDQ Single-Ended PAM-4 LVSTL Transmitter With FFE and In-Lane DBI for Low-Power Memory Interfaces
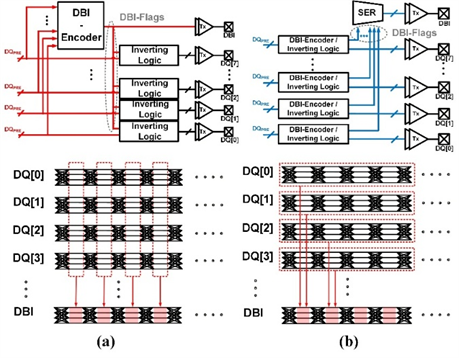
[연구자명] 송한얼, 최한민, 김성훈, 이선규 [연구제목] A 40-Gb/s 0.6-VDDQ Single-Ended PAM-4 LVSTL Transmitter With FFE and In-Lane DBI for Low-Power Memory Interfaces [연구내용 요약] 저전력·고속 메모리 인터페이스 구현을 위해 40Gb/s PAM-4 LVSTL 송신기를 40nm CMOS 공정으로 설계하였음. 각 데이터 lane 내부에서 독립적으로 동작하는 In-Lane Data Bus Inversion(DBI) 기법을 제안하여 기존 다중 lane DBI 구조에서 요구되는 전역 데이터 라우팅을 제거하고, 이에 따른 배선 복잡도와 timing skew 문제를 완화하였음. 또한 de-emphasis FFE를 적용하여 12dB 채널 손실을 보상하였으며, 시뮬레이션을 통해 평균 종단 전류 2.3mA와 0.44pJ/b의 에너지 효율을 달성하였음. [성과와 관련된 이미지 및 설명] (a) 기존 DBI-DC 수행 알고리즘 (b) 제안하는 In-Lane DBI-DC 수행 알고리즘 제안한 아이디어의 Architecture 및 소모 전력 [연구결과의 진행상태 및 향후 계획] 40Gb/s 동작의 0.6-VDDQ PAM-4 LVSTL 송신기를 개발하였음. 채널 손실을 보상하기 위한 de-emphasis FFE와 lane 내부에서 독립적으로 동작하는 DBI 기법을 적용하여, 복잡한 multi-lane 통합 과정 없이 높은 전압 레벨의 심볼 발생을 줄이고 전력 소모를 개선하였음. 시뮬레이션을 통해 12dB의 채널 손실 보상 성능을 확인하였으며, 평균 termination 전류 2.3mA와 0.44pJ/b의 에너지 효율을 달성하였음. 향후에는 송신단에서 데이터 패턴과 FFE 동작을 함께 고려하여 PAM-4 심볼 매핑을 최적화하는 기법을 연구할 계획임. 송신단이 전송할 데이터와 FFE 계수를 사전에 알고 있다는 점을 활용하여, 데이터 패턴에 따라 DBI 매핑을 적응적으로 결정함으로써 termination 전류와 신호 전이로 인한 전력 소모를 추가로 줄이고, 고속 동작에서의 신호 무결성을 향상시키는 저전력 PAM-4 송신기 구조로 발전시키고자 함. [논문실적] 2026 International SoC Design Conference(ISOCC) 게재
이선규 교수 2026.09.15 161 -
[이선규 교수] A 25-Gb/s Single-Ended PAM-4 Transceiver With Amplitude-Tunable Crosstalk Cancellation for On-Silicon Interconnection
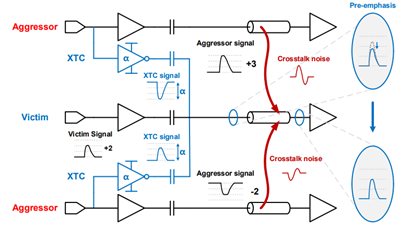
[연구자명] 조한빈 [연구제목] A 25-Gb/s Single-Ended PAM-4 Transceiver With Amplitude-Tunable Crosstalk Cancellation for On-Silicon Interconnection (온실리콘 인터커넥션을 위한 진폭 조절형 크로스토크 보상 기반 25-Gb/s 단일 종단 PAM-4 송수신기) [연구내용 요약] 고밀도 on-silicon interconnection에서 인접 aggressor 채널에 의해 발생하는 far-end crosstalk(FEXT)를 저감하기 위해 amplitude-tunable crosstalk cancellation(XTC) 기법을 제안하였다. 기존 resistance-tuned XTC와 달리, CXTC와 출력 저항 RS를 고정한 상태에서 XTC driver의 출력 진폭만 조절함으로써 RC time constant와 위상 특성을 유지하면서 다양한 채널 조건에 대응할 수 있도록 설계하였다. 제안한 XTC를 적용한 25-Gb/s PAM-4 송수신기를 28-nm CMOS 공정으로 설계하고, EM-extracted 5-channel on-chip interconnect model을 이용하여 victim eye opening 개선 효과를 검증하였다. [성과와 관련된 이미지 및 설명] 그림 1. Amplitude-tunable XTC의 동작 원리 그림 2. Independent data/XTC paths를 갖는 PAM-4 transmitter architecture 그림 3. 5-channel 3-mm on-chip interconnect를 적용한 simulation setup 그림 4. XTC 적용 전·후 victim eye diagram 비교: (a) Without XTC, (b) With XTC 인접한 두 aggressor 채널의 전이 정보를 이용하여 victim 채널에 반대 극성의 compensation signal을 주입하는 per-aggressor XTC 구조이다. 제안한 방식은 CXTC와 RS를 고정한 상태에서 amplitude coefficient α만 조절하므로 XTC 경로의 RC time constant와 phase response를 유지할 수 있다. 이를 통해 channel condition에 맞는 보상 강도를 설정하고, FEXT로 인해 닫힌 victim eye를 효과적으로 개선하였다. [연구결과의 진행상태 및 향후 계획] 28-nm CMOS 공정에서 amplitude-tunable XTC가 적용된 25-Gb/s PAM-4 송수신기의 설계와 시뮬레이션 검증을 완료하였다. EM 추출 5채널 온칩 인터커넥트 모델을 이용한 검증 결과, XTC coefficient α를 0.65–0.85 범위에서 조절하여 채널 길이 2.5–4 mm와 채널 간격 0.85–1 μm의 다양한 조건에서 크로스토크 보상 동작과 victim eye opening 개선을 확인하였다. 전체 소비전력은 19.5 mW이며, 0.781 pJ/bit의 에너지 효율을 달성하였다. 향후에는 본 연구에서 축적한 XTC 설계 및 채널 분석 경험을 바탕으로, 특정 채널 조건에 한정되지 않고 다양한 채널 환경에 범용적으로 적용할 수 있는 XTC 구조를 연구할 계획이다. 또한 채널 조건에 따른 기존 보상 방식의 한계를 분석하고, XTC 성능과 eye margin, BER 및 전력 효율을 종합적으로 고려하여 고속 메모리 인터페이스에 적합한 확장성 높은 XTC architecture로 발전시키고자 한다. [논문실적] ISOCC 2026 논문 채택 H. Jo, S.-B. Kim, M. Kim, and S.-K. Lee, “A 25-Gb/s Single-Ended PAM-4 Transceiver With Amplitude-Tunable Crosstalk Cancellation for On-Silicon Interconnection,” ISOCC 2026. 학부생 연구임에도 불구하고 학부생 논문트랙이 아닌 정규트랙에 제출하여 구두발표에 채택됨.
이선규 교수 2026.09.15 146 -
[강석형 교수] SpectraPlace2.5D: Thermal-aware Chiplet Placement via Topology-guided MILP and Spectral Thermal Modeling
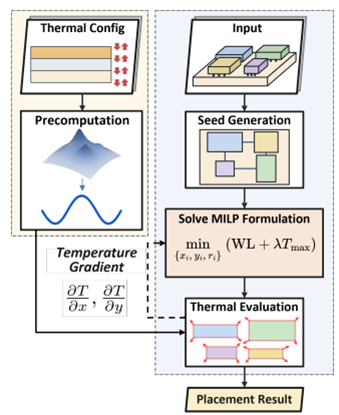
[연구자명] 서준영, 조현정, 이현재, 김현우, 강석형(지도교수) [연구제목] SpectraPlace2.5D: Thermal-aware Chiplet Placement via Topology-guided MILP and Spectral Thermal Modeling [연구내용 요약] 2.5D chiplet 시스템의 wirelength와 thermal hotspot을 동시에 최적화하기 위해 topology-guided seed generation, MILP placement, spectral thermal modeling을 결합한 thermal-aware chiplet placement 방법을 제안하였다. MILP 내에서 chiplet 위치·회전·non-overlap을 직접 고려하여 별도의 legalization을 제거하고, Green’s function 기반 spectral thermal model을 통해 placement 과정에서 온도를 빠르게 추정하였다. [성과와 관련된 이미지 및 설명] Topology 및 thermal-aware 2.5D chiplet placement framework Chiplet 연결 topology를 이용해 초기 placement를 생성하고 MILP 기반 legal placement를 수행한 후, spectral thermal model을 이용하여 온도 gradient를 계산하고 placement를 반복적으로 개선함. [연구결과의 진행상태 및 향후 계획] 10개의 공개 2.5D chiplet benchmark에 대한 실험을 완료하였다. 기존 ATPlace2.5D 대비 thermal-aware placement에서 평균 wirelength 27.1% 감소, 최대 chiplet 온도 1.52 K 감소, 전체 runtime 29.0% 감소를 달성하였다. 향후 routing 및 power delivery까지 고려한 chiplet physical design co-optimization과 대규모 chiplet 시스템으로 확장할 예정이다. [성과] 32nd Asia and South Pacific Design Automation Conference (APS-DAC 2027)
강석형 교수 2026.09.08 171 -
[강석형 교수] Phase-Aware Monte Carlo Tree Search with LLM-Guided Proposal for Multi-Objective Physical Design Tuning
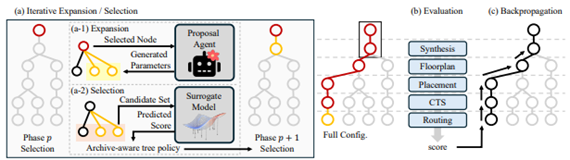
[연구자명] 윤종호, 최정현, 서재민, 강석형(지도교수) [연구제목] Phase-Aware Monte Carlo Tree Search with LLM-Guided Proposal for Multi-Objective Physical Design Tuning [연구내용 요약] EDA physical design flow의 다양한 설계 파라미터를 효율적으로 탐색하기 위해 각 설계 단계를 phase별 search tree로 모델링한 MCTS 기반 design-space optimization 방법을 제안하였다. LLM을 이용하여 각 phase의 유망한 parameter 후보를 생성하고, surrogate model과 실제 P&R 결과를 활용하여 제한된 full-flow 실행 횟수 내에서 PPA Pareto-optimal solution을 효과적으로 탐색하였다. [성과와 관련된 이미지 및 설명] LLM과 MCTS를 활용한 phase-aware physical design parameter tuning. Synthesis부터 routing까지의 parameter 결정을 tree 형태로 탐색하고, LLM이 후보 parameter를 생성하며 surrogate prediction과 실제 P&R 결과를 이용해 유망한 탐색 영역에 evaluation budget을 집중함. [연구결과의 진행상태 및 향후 계획] OpenROAD 기반 2개 공정 및 3개 benchmark에 대한 실험을 완료하였다. 동일한 full-flow evaluation budget에서 기존 방법 대비 평균 HV-Error를 31%, ADRS를 52% 감소시켰으며, clean-feasible solution 비율을 85.1%까지 향상시켰다. 또한 평균적으로 전체 evaluation budget의 47%만으로 기존 최우수 baseline의 최종 성능에 도달하였다. 향후 더 많은 design/PDK 및 대규모 parameter space에 대한 적용을 진행할 예정이다. [성과] 32nd Asia and South Pacific Design Automation Conference (APS-DAC 2027)
강석형 교수 2026.09.08 134 -
[강석형 교수] DPSQ: Dynamic Partial Sum Quantization with Mixed Granularity
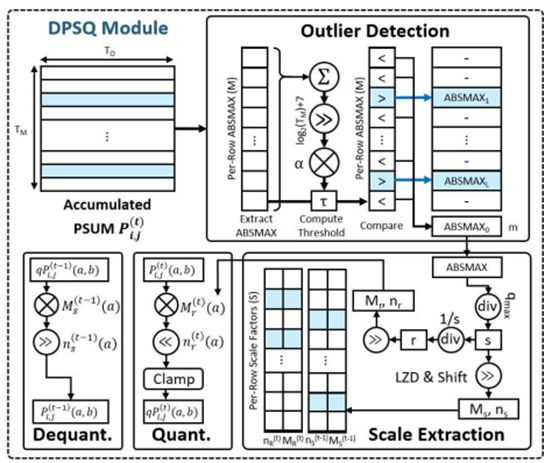
[연구자명] 김준석, 권도원, 강석형(지도교수) [연구제목] DPSQ: Dynamic Partial Sum Quantization with Mixed Granularity [연구내용 요약] Transformer accelerator의 Input/Weight Stationary dataflow에서 발생하는 대규모 Partial Sum(PSUM) off-chip memory traffic을 감소시키기 위한 dynamic quantization 방법을 제안하였다. PSUM의 sparse outlier 특성을 분석하여 outlier vector에만 fine-grained dynamic quantization을 적용하고 나머지 vector는 scale을 공유하는 mixed-granularity DPSQ를 통해 정확도와 하드웨어 효율을 동시에 확보하였다. [성과와 관련된 이미지 및 설명] Mixed-granularity Dynamic PSUM Quantization. PSUM 내 일부 outlier vector에 대해서만 독립적인 quantization scale을 사용하고, 일반 vector들은 하나의 scale을 공유하여 dynamic quantization의 연산 오버헤드를 감소시킴. [연구결과의 진행상태 및 향후 계획] BERT, LLaMA 및 Vision Transformer를 대상으로 software evaluation을 수행하고, ZCU104 FPGA에서 DPSQ accelerator를 구현하였다. Mixed DPSQ는 unquantized fused OS–IS 대비 50.4%의 에너지 절감을 달성하였으며, FPGA에서 0.952 ms latency를 기록하여 기존 outlier-aware 방법 대비 latency 및 area-time product를 개선하였다. 향후 end-to-end Transformer accelerator와의 통합 및 저비트 PSUM quantization으로 확장할 예정이다. [성과] 32nd Asia and South Pacific Design Automation Conference (APS-DAC 2027)
강석형 교수 2026.09.08 192
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 다음 페이지로 이동하기
- 마지막 페이지로 이동하기