

최신 연구
[정윤영 교수] Real-Time Speech Enhancement on Edge Devices Guided by Harmonic and Voice-Activity Cues Utilizing Skin-Attachable Accelerometer
- 등록일2026.10.26
- 조회수44
-

교수정윤영
정윤영 교수 연구팀은 일반 마이크와 피부 부착형 가속도 센서를 결합하여, 극심한 소음 환경에서도 사람의 목소리를 선명하게 복원할 수 있는 초경량 인공지능 모델 LAU-NetV2를 개발하였다. 일반 마이크는 주변 소음까지 함께 수집하는 반면, 피부 부착형 가속도 센서는 사람이 말할 때 발생하는 목의 미세한 진동을 감지해 외부 소음의 영향을 상대적으로 적게 받는다.
연구팀은 이러한 특성을 활용하여 가속도 센서에서 발화 구간과 음성의 하모닉 정보를 추출하고, 이를 인공지능 모델에 반영하여 배경 소음을 효과적으로 제거하는 기술을 구현하였다. 특히 기존 멀티모달 음성 향상 모델 대비 인공지능 파라미터 수를 약 1/68 수준으로 줄였다. 또한, 설계의 바탕이 된 기본 모델과 비교해 음성 품질 평가 지표인 PESQ 점수를 1.78에서 2.78로 향상시켰다.
또한 신경망 채널을 40% 경량화하여 소형 제어 장치에서의 추론 시간을 48.66 ms까지 단축하였으며, 약 92.3 dBA의 소음이 발생하는 실제 서버실에서도 음성 복원 성능을 확인하였다. 이번 연구는 산업 현장과 공사장 등 소음이 심한 환경에서 활용되는 웨어러블 통신 기기의 실시간 음성 향상 기술로 적용될 수 있을 것으로 기대된다.
[연구자명]
- 송용훈, 김영민, 김윤식, 김예은, 정윤영(교신저자)
[연구제목]
- Real-Time Speech Enhancement on Edge Devices Guided by Harmonic and Voice-Activity Cues Utilizing Skin-Attachable Accelerometer
- [연구내용 요약]
- 공장이나 공사장과 같이 소음이 심한 환경에서는 주변의 기계 소음으로 인해 사람의 목소리가 잘 전달되지 않는 문제가 있다. 이러한 환경에서 일반 마이크는 사람의 목소리뿐만 아니라 주변 소음까지 함께 수집하기 때문에 음성의 명료도가 떨어지며, 기존 인공지능 기반 소음 제거 기술 역시 소음이 목소리보다 큰 환경에서는 음성을 정확하게 복원하기 어렵다는 한계가 있다. 반면, 피부 부착형 가속도 센서는 사람이 말할 때 목의 피부에서 발생하는 미세한 진동을 직접 감지하여 외부 소음의 영향을 상대적으로 적게 받는다. 다만 진동이 신체 조직을 통과하면서 고주파 성분이 약해지기 때문에, 가속도 센서만으로는 선명한 음성을 얻기 어렵다는 문제가 있다.
이에 연구팀은 일반 마이크와 피부 부착형 가속도 센서의 장점을 결합한 초경량 인공지능 모델 LAU-NetV2를 개발하였다. 이 모델은 가속도 센서로부터 사람이 실제로 말하는 시간대를 나타내는 발화 구간(VAD) 정보와 목소리의 규칙적인 주파수 패턴을 나타내는 하모닉(Harmonic) 정보를 추출하여 음성 복원에 활용한다. 발화 구간 정보는 사람이 말하지 않는 시간대의 배경 소음을 억제하는 데 도움을 주며, 하모닉 정보는 성대 진동에서 발생하는 기본 주파수와 그 정수배 성분을 바탕으로 음성의 고유한 구조를 보존하도록 돕는다.
연구팀은 이러한 두 가지 음성 정보를 인공지능에 효과적으로 반영하기 위해 FiLM(Feature-wise Linear Modulation) 기법을 적용하였다. FiLM은 입력된 정보에 따라 인공지능이 분석하는 특징을 선택적으로 강조하거나 억제하는 방식으로, 하모닉 정보를 통해 음성의 주파수 구조를 보존하고 발화 구간 정보를 통해 불필요한 배경 소음을 줄이도록 설계하였다. 이를 통해 대규모 신경망을 사용하지 않고도 효과적인 음성 복원이 가능하도록 하였다. 실제 개발된 모델의 파라미터 수는 약 45,590개로, 대표적인 기존 멀티모달 음성 향상 모델 대비 약 1/68 수준으로 감소하였다.
개발된 모델의 성능을 평가한 결과, 마이크 신호만 활용한 기본 모델의 평균 PESQ(음성 품질 평가 지표) 점수는 1.78이었으나, 발화 구간과 하모닉 정보를 모두 활용한 LAU-NetV2 모델은 2.78을 기록하였다. 또한 음성 명료도를 평가하는 STOI와 음성 및 배경 소음의 품질을 예측하는 DNSMOS P.835 지표에서도 성능을 평가하였으며, 특히 주변 소음이 목소리와 같거나 더 큰 환경에서 비교 모델보다 높은 음질 및 명료도 성능을 보였다.
나아가 연구팀은 소형 웨어러블 기기에서의 실시간 구동을 위해 신경망 채널을 40% 경량화하였다. 그 결과, 소형 제어 장치에서 모델의 추론 시간이 기존 87.12 ms에서 48.66 ms로 단축되었으며, PESQ 점수는 2.78에서 2.62로 약 5.8% 감소하였지만 실시간 처리에 필요한 시간 조건을 충족하였다. 또한 약 92.3 dBA의 소음이 발생하는 실제 서버실에서 시연을 진행하여 배경 소음이 억제되고 음성의 하모닉 구조가 보존되는 것을 확인하였다. 이번 연구는 제한된 연산 자원을 가진 초소형 웨어러블 기기에서도 실시간 음성 향상이 가능함을 보여주었으며, 향후 산업 현장이나 공사장 등 소음이 심한 환경에서 사용하는 착용형 통신 기기에 활용될 수 있을 것으로 기대된다.
[성과와 관련된 이미지 및 설명]
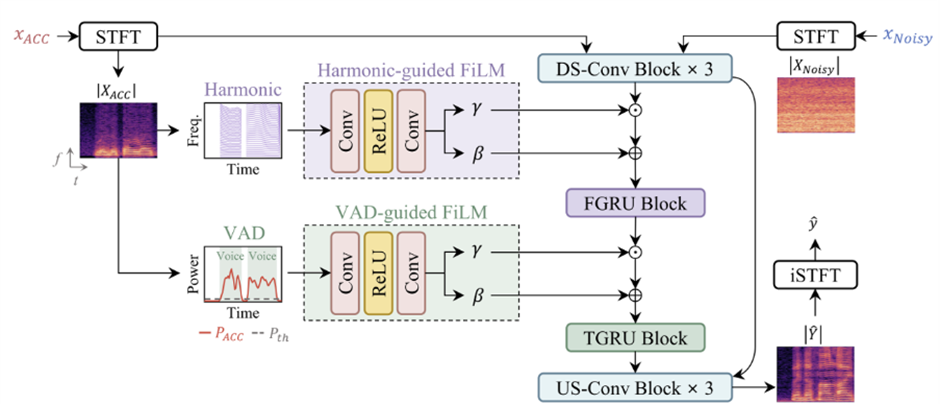
위 그림은 일반 마이크와 피부 부착형 가속도 센서를 활용하여 음성을 복원하는 LAU-NetV2 모델의 작동 원리를 나타낸 그림이다. 먼저 두 센서에서 수집한 신호를 시간-주파수 영역으로 변환하고, 가속도 센서 신호에서 발화 구간(VAD)과 하모닉(Harmonic) 정보를 추출한다. 이후 FiLM 기법을 활용하여 추출된 정보를 인공지능 모델에 반영함으로써 마이크 신호에 포함된 배경 소음을 억제하고 음성의 고유한 주파수 구조를 보존한다. 최종적으로 복원된 신호를 음성 파형으로 변환하여 선명한 목소리를 출력한다.
[연구결과의 진행상태 및 향후 계획]
본 연구진은 이번 연구에서 개발한 피부 부착형 가속도 센서와 초경량 인공지능 기반 음성 향상 기술을 스마트 글래스에 적용하는 후속 연구를 진행할 계획이다. 특히 스마트 글래스의 코 패드에 진동 센서를 장착하여 사용자가 말할 때 발생하는 미세한 진동을 측정하고, 이를 인공지능 모델로 처리하여 음성을 복원하는 기술을 연구할 예정이다. 이를 통해 안경을 착용하는 방식으로도 소음이 심한 환경에서 사용자의 목소리를 선명하게 전달할 수 있는 기술을 개발하고자 한다.
[논문실적]
Interspeech 2026 [Published]
DOI: 10.21437/Interspeech.2026-3119